У крупного маркетплейса есть проблема, о которой снаружи не догадываются: контент. Чтобы товар появился на портале, его надо получить от поставщика, привести к внутреннему формату, разложить по категориям и регулярно обновлять. Поставщиков десятки, и каждый отдает данные по-своему.
Начали с одного прайса. Сейчас работает около двадцати источников, и новые добавляются регулярно.
Модель работы: платеж за источник
Договорились сразу: оплата считается за каждый источник отдельно, ежемесячно. Эта схема оказалась удобной обеим сторонам, и я теперь часто ее предлагаю.
- Заказчику понятно, за что платит. Добавили поставщика – добавился платеж. Поставщик отвалился – платеж ушел. Никаких переговоров о пересмотре общей суммы.
- Легко начать. Первый прайс стоит столько же, сколько один прайс, а не как “проект интеграции”. Порог входа низкий.
- Исполнителю честно. Каждый источник – это реальная работа и реальный риск поломки. Двадцать источников требуют в двадцать раз больше внимания, чем один.
- Рост происходит сам. Заказчик не спрашивает разрешения и не запускает процесс согласования бюджета, он просто пишет: “вот еще один поставщик”.
Еще один плюс такой схемы: если бизнесу нужно временно сократить расходы, можно остановить часть источников, а не весь проект, и потом так же легко их вернуть.
Что приходит от поставщиков
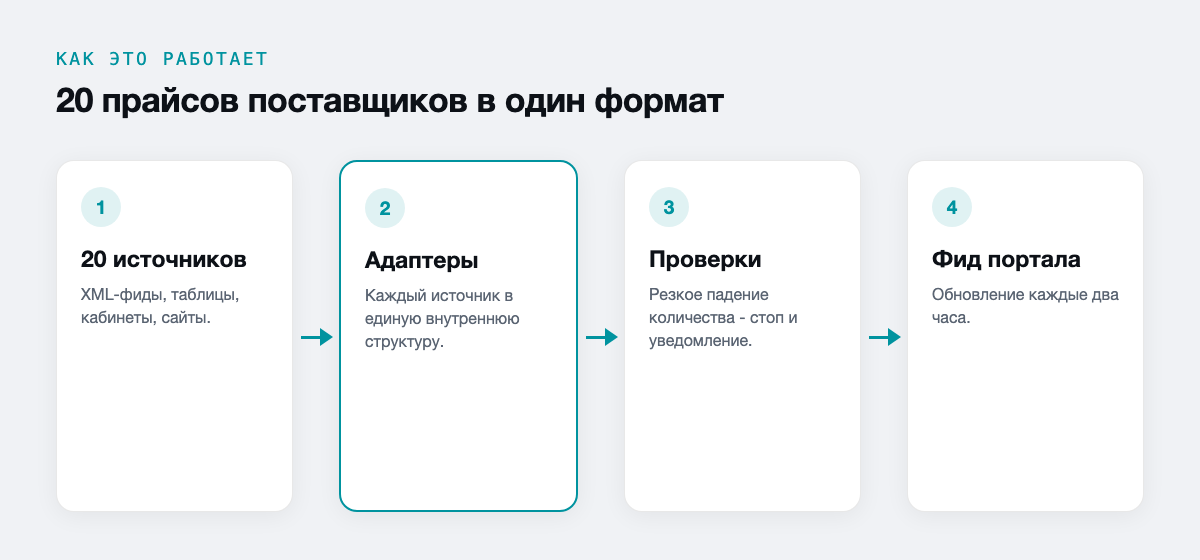
Двадцать источников – это четыре принципиально разных типа.
XML-фиды по ссылке
Самый удобный вариант. Поставщик дает адрес, по которому лежит актуальный файл. Сложность только в том, что структура у всех разная: разные названия полей, разная вложенность, разная логика категорий и характеристик.
Google Таблицы
Примерно четверть источников ведется руками в таблицах. Это самый непредсказуемый формат: люди добавляют колонки, меняют порядок, пишут примечания в ячейках с ценами, вставляют пустые строки-разделители. Обработка таких источников должна быть параноидальной и не верить ничему.
Личные кабинеты с авторизацией
Поставщик выдает доступ к своему кабинету, откуда надо забирать каталог. Скрипт заходит под выданными данными и собирает информацию. Здесь главное – аккуратность: сессия, лимиты, корректное поведение. Работу от имени клиента с его же доступом я делаю только по прямому поручению.
Обычные сайты
Иногда у поставщика нет никакой выгрузки, есть только сайт. Тогда данные собираются прямо с него.
Единый внутренний формат – главное архитектурное решение
Соблазн написать двадцать отдельных скриптов “из источника сразу в формат портала” велик. Это ошибка, которая становится очевидной на пятом источнике.
Правильная схема – два слоя:
- Адаптер источника. Знает только одно: как достать данные у конкретного поставщика и привести их к единой внутренней структуре.
- Формирователь выгрузки. Знает только внутреннюю структуру и требования портала.
Что это дает:
- портал изменил требования к фиду – правится один формирователь, а не двадцать скриптов;
- новый поставщик – пишется только адаптер, остальное уже готово;
- проверки качества данных пишутся один раз и работают для всех источников;
- новый адаптер добавляется быстро и без переделки остального.
Именно поэтому добавление новых прайсов в этом проекте идет потоком и не вызывает у меня паники.
Проверки, без которых нельзя
Когда источников двадцать, руками проверять невозможно. Поэтому каждая выгрузка проходит автоматический контроль:
- количество товаров резко упало по сравнению с предыдущим разом – стоп и уведомление;
- у большинства позиций исчезла цена – стоп;
- появились нулевые или отрицательные цены – позиции отбрасываются;
- дубли по артикулу внутри одного источника – сводятся по заданному правилу;
- кодировка и спецсимволы – проверяются перед формированием файла.
Принцип простой: лучше не обновить каталог совсем, чем обновить его мусором. Пустой прайс на портале заметят за час, а тихо испорченные цены могут жить неделями и стоить денег.
Обновление раз в два часа
Частота подобрана под бизнес: данные должны быть свежими, но постоянное долбление источников никому не нужно. Двадцать источников обновляются по расписанию, разнесенному по времени, чтобы не создавать пиков нагрузки ни на сервере, ни у поставщиков.
Отдельно стоит сказать о разных скоростях. Не все источники нужны одинаково часто: у кого-то прайс меняется несколько раз в день, у кого-то раз в неделю. Расписание под каждый источник настраивается отдельно.
Что это дает бизнесу
- Контент-команда не занимается механической работой. Люди работают над качеством карточек, а не над перекладыванием колонок.
- Новый поставщик подключается быстро. Это прямо влияет на скорость роста ассортимента.
- Данные однородны. Все товары на портале выглядят одинаково независимо от того, от кого пришли.
- Проблемы видны сразу. Если поставщик сломал свой прайс, об этом известно в тот же день, а не когда пожалуется покупатель.
Кому подходит такая схема
Маркетплейсам, агрегаторам, дистрибьюторам и любым магазинам, работающим более чем с тремя-четырьмя поставщиками. Точка, после которой ручная обработка становится дороже автоматизации, наступает очень быстро – обычно на третьем-четвертом источнике.
Признак, что вам это уже нужно: в компании есть человек, который значительную часть недели занимается перекладыванием прайсов в нужный формат.
Опишите, сколько у вас поставщиков и в каком виде они отдают данные. Я скажу, сколько времени займет первый источник и как будет выглядеть подключение следующих. Подробнее о форматах – на странице конвертация прайс-листа поставщика в YML.