Компания подбирает для своих клиентов подержанные автомобили из Европы. Запросы приходят каждый день: нужна такая-то модель, не старше такого-то года, с пробегом до стольких-то километров, в пределах бюджета. Менеджер открывает двадцать европейских площадок, вручную вбивает запрос в каждую, листает выдачу и копирует подходящее в свою табличку. На один запрос уходит от сорока минут до полутора часов.
Задача звучала просто: менеджер вводит запрос в одном месте, а через несколько минут получает сводную таблицу со всех двадцати сайтов. Ниже – как это устроено изнутри, с какими проблемами пришлось разобраться и почему интерфейсом стала обычная Google Таблица, а не веб-приложение.
Почему интерфейсом стала Google Таблица
Первое, что приходит в голову в такой задаче, – сделать сайт с формой поиска. Я от этого отказался сознательно, и вот почему.
- Нулевой порог входа. Менеджеры и так работают в таблицах целый день. Новый интерфейс означал бы обучение, инструкции, сопротивление. Таблицу не нужно объяснять.
- Не нужна авторизация. Доступ к документу раздает руководитель через обычный доступ Google. Пришел новый сотрудник – добавили почту, ушел – убрали. Никакой собственной системы пользователей и паролей.
- История запросов складывается сама. Каждая строка на главном листе – это сохраненный запрос с датой, автором и ссылкой на результат. Руководитель видит, кто что искал, без отдельных отчетов.
- Результат сразу пригоден к работе. Менеджер фильтрует, сортирует, ставит свои пометки прямо в том же документе. Ничего не нужно выгружать и куда-то переносить.
Таблица здесь – это оболочка. Вся работа происходит на сервере, а таблица только принимает запрос и показывает результат.
Как это работает шаг за шагом
1. Менеджер вводит запрос
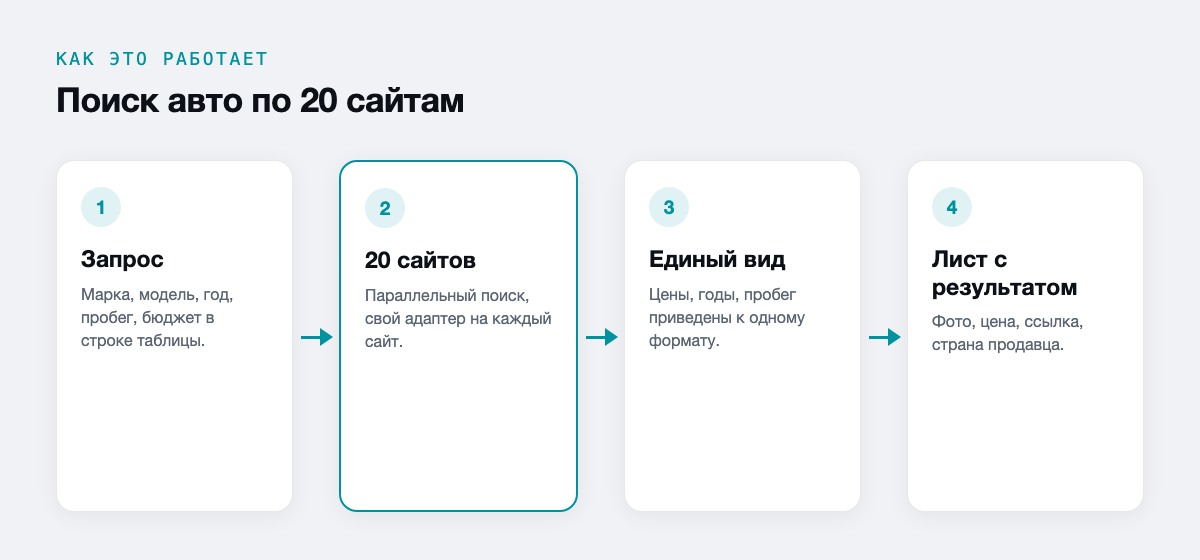
На главном листе есть несколько колонок: марка, модель, год, пробег и бюджет. Менеджер заполняет строку. Скрипт, привязанный к таблице, ловит изменение и отправляет запрос на сервер.
2. Сервер раскладывает запрос на двадцать отдельных
Двадцать европейских площадок – это двадцать разных сайтов. Каждый со своей структурой, своими названиями категорий и своей логикой поиска. Один ищет по параметрам в адресе, второй – через внутренний API, третий требует форму с токеном со страницы, четвертый отдает результаты частями при прокрутке.
Поэтому для каждого сайта написан свой адаптер: он знает, как превратить запрос менеджера в корректный поиск именно на этой площадке, как пройти пагинацию и где на странице лежат нужные поля. Сверху – общий диспетчер, который запускает все адаптеры параллельно и собирает ответы в один список.
3. Приведение к единому виду
Это самая скучная и самая важная часть. С каждого сайта приходит своя каша:
- цена может быть “45 000 EUR”, “45.000,00 €”, “EUR 45000” или “цена по запросу”;
- год выпуска бывает отдельным полем, а бывает внутри названия;
- пробег указывают в километрах, милях или не указывают вовсе;
- фото иногда лежит прямой ссылкой, иногда прячется за скриптом галереи.
Все это нормализуется: цена приводится к числу и валюте, год – к четырем цифрам, пробег – к километрам, ссылка на фото проверяется на доступность. Если поле достать не удалось, оно остается пустым, а не заполняется мусором. Пустая ячейка честнее неправильного числа.
4. Результат ложится на новый лист
Под каждый запрос создается отдельный лист: фото, название, ссылка на оригинальное объявление, цена, год, пробег, страна продавца, площадка-источник. На главном листе, в той же строке, куда менеджер вводил запрос, появляется ссылка на этот лист.
Менеджер видит все на одном экране, фильтрует по цене и году, открывает нужное объявление и связывается с продавцом.
Технические проблемы, с которыми пришлось разобраться
Лимиты Google Таблиц
Таблица не безгранична: есть потолок по количеству ячеек и листов в документе. Ежедневные запросы, каждый со своим листом на сотни строк, – и за несколько месяцев документ пухнет. Поэтому старые листы архивируются: результаты старше определенного срока переносятся в отдельный документ, а ссылка на главном листе остается рабочей.
Скорость
Последовательный обход двадцати сайтов занимал бы много минут. Запросы идут параллельно, с ограничением на количество одновременных соединений к одному домену, чтобы не нагружать источник. В сумме поиск укладывается в несколько минут.
Сайты постоянно меняются
Это главная статья расходов в таком проекте, и о ней стоит говорить честно. Площадки регулярно меняют верстку, структуру адресов или способ отдачи данных. Поэтому предусмотрен мониторинг: если адаптер возвращает подозрительно мало результатов или ноль там, где раньше стабильно что-то было, я получаю уведомление и иду смотреть, что изменилось.
Именно поэтому подобные проекты живут в формате ежемесячной поддержки, а не разовой разработки. Разово сделанный поисковик по двадцати сайтам перестанет работать за несколько месяцев, и обычно в самый неудачный момент.
Защита от ботов
Часть площадок стоит за защитой, которая отсеивает автоматические запросы. Это решается корректным поведением клиента, разумной частотой обращений и, где нужно, прокси. Подробнее о подходах я писал на странице парсинг сайтов с защитой от ботов.
Что получил бизнес
Главное изменение даже не в экономии времени, хотя она очевидна: то, что занимало час, теперь занимает несколько минут ожидания. Важнее другое.
- Полнота охвата. Под конец дня человек устает и проверяет пять сайтов вместо двадцати. Скрипт проверяет все двадцать всегда, независимо от настроения и загрузки.
- Скорость ответа клиенту. На рынке подержанных авто выигрывает тот, кто первым предложил вариант. Разница между “перезвоню завтра” и “вот три варианта, смотрите” – это разница между сделкой и потерянным клиентом.
- Одинаковый результат у всей команды. Опытный менеджер и новичок получают одинаково полную выборку. Знание о том, “где именно искать”, перестало быть личным активом отдельных людей и стало активом компании.
- Управляемость. Руководитель видит все запросы в одном документе: что искали, как часто, на что самый большой спрос.
Кому подойдет такая схема
Схема “запрос в таблице – обработка на сервере – результат отдельным листом” работает везде, где несколько человек регулярно ищут одно и то же на многих источниках:
- закупщики, сравнивающие предложения поставщиков;
- агентства недвижимости, собирающие объявления по городам и районам;
- отделы продаж, проверяющие наличие товара у конкурентов;
- компании, отслеживающие тендерные и аукционные площадки.
Вместо таблицы интерфейсом может быть группа в Telegram: человек пишет запрос сообщением, бот отвечает ссылкой на готовый файл. Такой вариант я тоже делаю и часто предлагаю, когда пользователей мало, а запросы редкие.
Сколько это стоит и сколько занимает
Стоимость зависит от количества источников и от того, насколько сложно с каждого достать данные. Двадцать сайтов, часть из которых под защитой, – это уже полноценный проект.
Дальше идет ежемесячная поддержка: сервер, прокси, мониторинг и, главное, адаптация парсеров, когда источники меняются. Без поддержки такой проект не имеет смысла – он просто тихо умрет за несколько месяцев.
Если у вас похожая задача, опишите ее – за пятнадцать-двадцать минут разговора я скажу, решается ли она, сколько источников реально потянуть и во что это обойдется. Консультация ни к чему не обязывает.